پیام خراسان - دبیر فرهنگستان زبان و ادب فارسی از برنامه این فرهنگستان برای آمادهسازی و دسترسپذیر کردن گنجینه دادههای زبان فارسی با هدف ارتقای عملکرد هوش مصنوعی در شناخت و پردازش این زبان خبر داد.
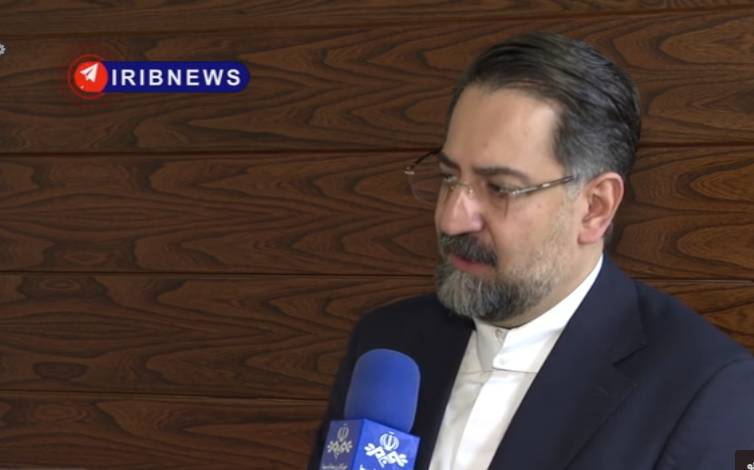
سیدمجتبی حسینی در مصاحبه با خبرنگار خبرگزاری صدا وسیما، با اشاره به ظرفیتهای دادهای فرهنگستان زبان و ادب فارسی گفت: فرهنگستان در سه دهه گذشته مجموعه ارزشمندی از دادههای زبان فارسی را گردآوری و تولید کرده است که میتواند در بهبود عملکرد سامانههای هوش مصنوعی و اصلاح خطاهای آنها در شناخت زبان فارسی مؤثر باشد.
وی افزود: هوش مصنوعی با دریافت جملات و عبارتهای کاربران و رسانهها، الگوهای زبانی را شناسایی میکند؛ اما این دادهها ممکن است با خطاهای زبانی همراه باشند. از این رو، بهرهگیری از دادههای معتبر و علمی فرهنگستان میتواند به شناخت دقیقتر زبان فارسی در این سامانهها کمک کند.
دبیر فرهنگستان زبان و ادب فارسی همچنین از برگزاری نشستهای تخصصی «هماندیشی کنشگران رایاسپهر فارسی، دربارۀ مسائل زبان فارسی در فضای دیجیتال» با حضور شرکتها و مؤسسات فعال در حوزه فناوریهای زبانی خبر داد و گفت: در این نشستها، متخصصان زبان و ادبیات فارسی در کنار مهندسان و فعالان حوزه فناوری، ظرفیتها و چالشهای این حوزه را بررسی میکنند.
حسینی با اشاره به نتایج این نشستها، یکسانسازی دستور خط فارسی را از ضرورتهای مهم توسعه فناوریهای زبانی دانست و افزود: تفاوت در شیوه نگارش، فاصلهگذاری و استفاده از علائم سجاوندی میتواند برای سامانههای هوش مصنوعی خطا ایجاد کند.
وی توضیح داد: حتی شیوه درج اعداد و استفاده از علائم اعشاری نیز در پردازش دادهها اهمیت دارد؛ بنابراین، تدوین و رعایت قواعد نگارشی یکسان میتواند زمینه ایجاد بانک داده ملی و پردازش دقیقتر اطلاعات فارسی را فراهم کند.
دبیر فرهنگستان زبان و ادب فارسی گفت:هر هفته یکی از شرکتهای فعال در حوزه فناوریهای زبانی محور بحث قرار میگیرد و دیگر فعالان این عرصه نیز در بررسی مسائل و ارائه راهکارها مشارکت میکنند.
سه شنبه گذشته سومین جلسه از سلسلهنشستهای «هماندیشی کنشگران رایاسپهر فارسی، دربارۀ مسائل زبان فارسی در فضای دیجیتال»، در فرهنگستان زبان و ادب فارسی، برگزار شد.